نماذج إنفيديا للذكاء الاصطناعي تتقن النجدية والحجازية: خفض أخطاء التعرف على الكلام بأكثر من النصف
▪︎ واتس المملكة
.
حققت شركة “إنفيديا” تقدماً كبيراً في تمكين نماذج الذكاء الاصطناعي من فهم اللهجات السعودية، بعد تدريب نموذج التعرف على الكلام Nemotron 3.5 ASR على بيانات صوتية باللهجتين النجدية والحجازية من مجموعة بيانات SADA. وأسهم هذا التدريب، الممتد لنحو 4.5 ساعات وباستخدام وحدتي معالجة رسومية، في خفض معدل الخطأ…
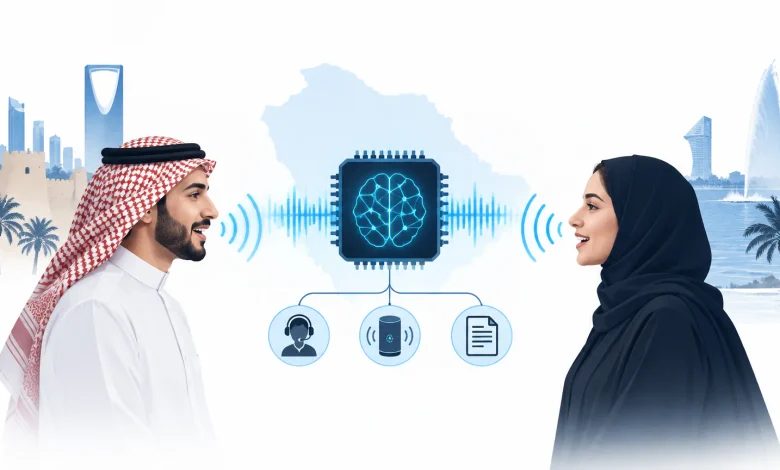
حققت شركة إنفيديا NVIDIA تقدماً في قدرة نماذج الذكاء الاصطناعي على فهم اللهجات السعودية، بعد تدريب نموذجها للتعرف على الكلام Nemotron 3.5 ASR على بيانات صوتية باللهجتين النجدية والحجازية.
وأوضحت الشركة أن عملية التخصيص اعتمدت على نحو 133.7 ساعة من التسجيلات الصوتية ضمن مجموعة بيانات SADA، بهدف تحسين قدرة النموذج على التعامل مع الاختلافات اللغوية واللهجية المحلية. (NVIDIA Developer)
ووفق النتائج التي نشرتها إنفيديا، انخفض معدل الخطأ في التعرّف على الكلمات للهجتين النجدية والحجازية من 55.05% قبل التدريب إلى 29.96% بعده، فيما تراجع معدل الخطأ على مستوى الأحرف من 31.63% إلى 12.18%.
واستغرقت عملية التدريب نحو 4.5 ساعات باستخدام وحدتي معالجة رسومية، وشملت أكثر من 12 ألف خطوة تدريبية، مع تحديث طبقات النموذج لتحسين استيعابه للخصائص الصوتية واللهجية.
ويأتي التطور في وقت تتزايد فيه تطبيقات الذكاء الاصطناعي الصوتي في خدمات العملاء، والمساعدات الرقمية، وتحويل المقابلات والاجتماعات إلى نصوص، إلى جانب استخداماته المتنامية في الإعلام والبث وصناعة المحتوى.
ويفتح تحسين فهم اللهجات المحلية الباب أمام تطبيقات صوتية أكثر ملاءمة للمستخدم السعودي، خصوصاً في خدمات التفريغ الآلي والمساعدات الصوتية والبحث داخل المحتوى المرئي والمسموع.
● تنويه لزوار الموقع (الجدد) :- يمكنك الإشتراك بالأخبار عبر الواتساب مجاناً انقر هنا ليصلك كل ماهو جديد و حصري .
Source sabq